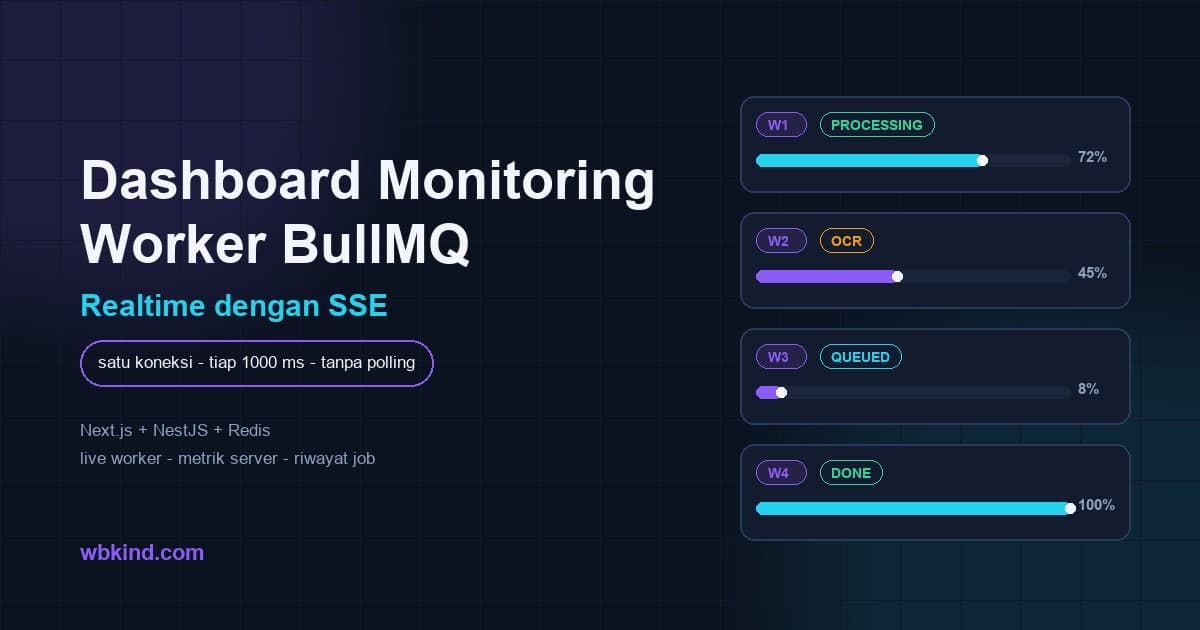
Pipeline OCR yang saya jalankan di produksi sempat jadi kotak hitam. Worker BullMQ jalan di VPS, antrean diproses setiap detik, tapi tiap kali ada gambar yang gagal saya baru tahu belasan menit kemudian dari laporan orang lapangan. Dari situ saya membangun dashboard monitoring realtime yang sekarang bisa diakses publik di domain kerja saya, dan artikel ini adalah catatan lengkap bagaimana dashboard itu dibangun: satu koneksi SSE untuk semua data, live worker activity, metrik server, sampai jebakan-jebakan yang saya alami saat memakai WebSocket dan polling di percobaan pertama.
Apa itu dashboard monitoring worker BullMQ?
Dashboard monitoring worker BullMQ adalah halaman web yang menampilkan kondisi antrean dan worker secara realtime: berapa job aktif, berapa yang menunggu, worker mana sedang memproses CN mana, di tahap apa prosesnya berjalan, dan berapa persen progresnya. Tanpa dashboard seperti ini, satu-satunya cara memeriksa antrean adalah menjalankan perintah ke Redis atau membaca log PM2 baris demi baris.
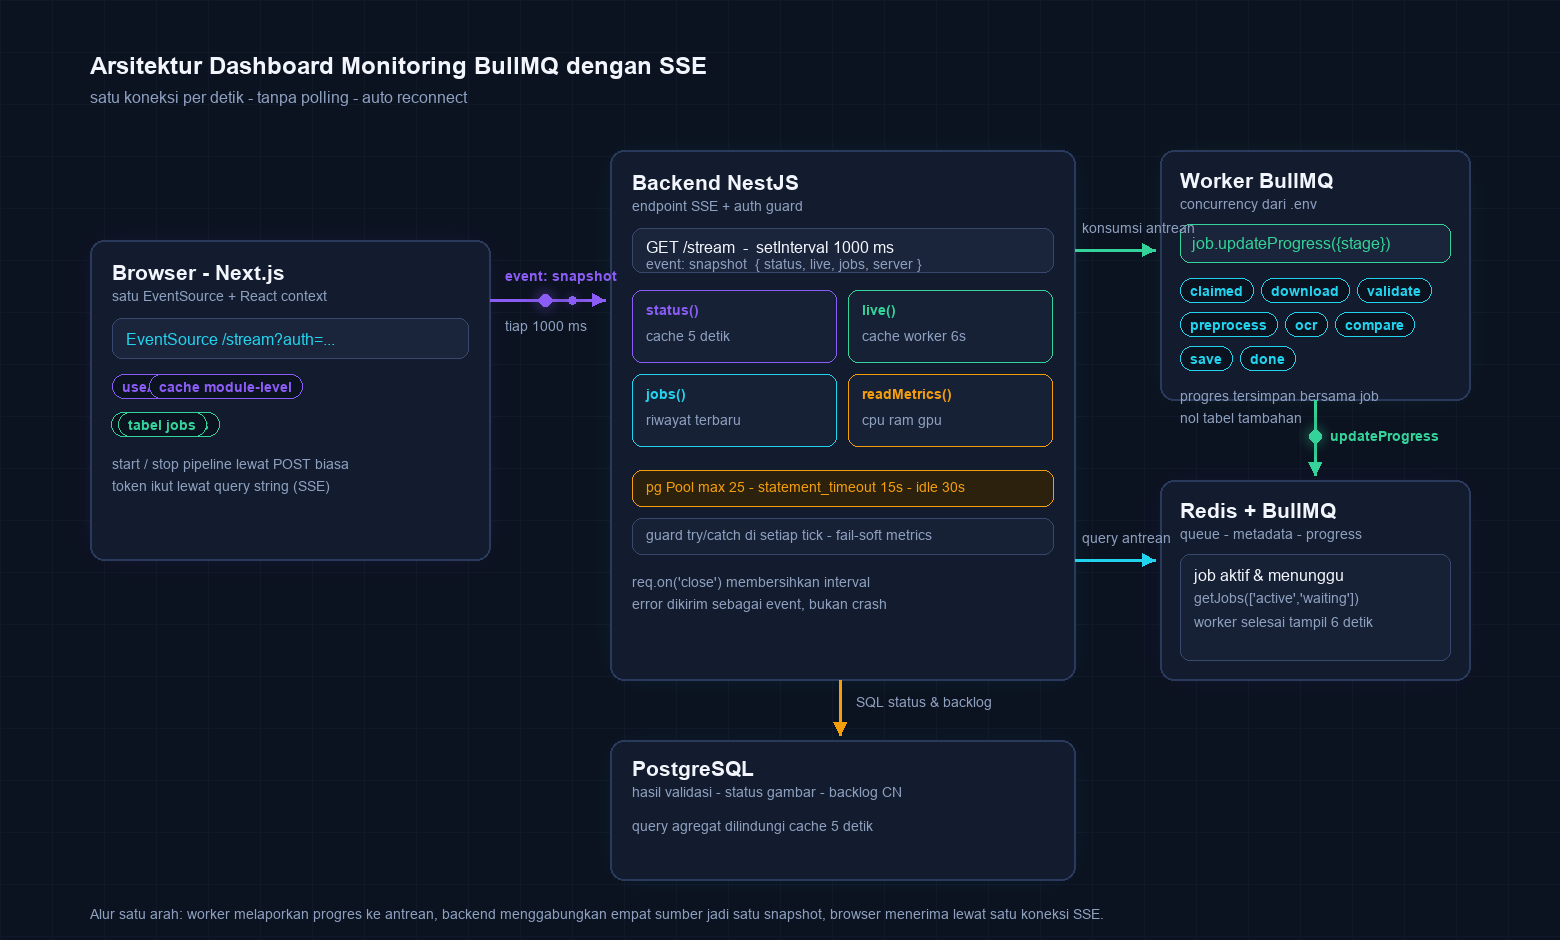
Dalam kasus saya, satu worker memproses satu CN yang berisi banyak gambar dokumen. Setiap gambar melewati tahap claimed, download, validate, preprocess, OCR, compare, sampai save. Dashboard harus bisa menunjukkan posisi setiap worker di rantai tahapan itu tanpa perlu refresh halaman.
Kenapa SSE dan bukan polling atau WebSocket
Cara paling umum yang saya lihat di banyak tutorial adalah polling: frontend memanggil endpoint status setiap beberapa detik dengan setInterval. Pendekatan ini bekerja, tapi boros. Kalau dashboard dibuka 10 orang dan polling berjalan tiap 2 detik, backend menjalankan 5 query agregat per detik hanya untuk menjawab pertanyaan yang sama. Ditambah lagi data selalu telat maksimal satu interval.
WebSocket adalah kandidat kuat untuk komunikasi dua arah, tapi untuk dashboard monitoring arah datanya cuma satu: server ke browser. Saya tidak butuh browser mengirim apa pun setelah koneksi terbuka, karena aksi seperti start dan stop pipeline cukup lewat POST biasa. WebSocket juga butuh server tambahan atau upgrade protokol yang harus diurus Caddy atau Nginx.
Server-Sent Events pas untuk kebutuhan ini. Browser membuka satu koneksi HTTP biasa, server menahan koneksi itu terbuka dan mengirim event setiap detik, browser menerima sebagai event bernama. Koneksi bersifat one-way tapi itu justru yang dibutuhkan, dan yang paling penting: EventSource di browser otomatis reconnect kalau koneksi putus, tanpa kode tambahan.
Arsitektur dashboard yang saya bangun
Arsitekturnya tiga lapis. Backend NestJS menyediakan endpoint stream yang setiap detik mengirim satu snapshot JSON berisi empat blok data sekaligus: status antrean, daftar worker aktif, job terbaru, dan metrik server. Frontend Next.js membuka satu EventSource ke endpoint itu dan menyebarkan data lewat React context ke seluruh komponen. Tidak ada komponen yang fetch sendiri, semua bersumber dari snapshot yang sama.
Keputusan penting pertama: satu snapshot berisi semuanya, bukan empat endpoint terpisah. Awalnya saya membuat endpoint live dan status terpisah, tapi dua EventSource ke dua endpoint berarti dua interval di server dan dua sumber kebenaran yang bisa saling timpang. Digabung jadi satu, tiap detik frontend menerima paket data yang konsisten secara atomik.
Keputusan kedua: worker melaporkan progres lewat mekanisme bawaan BullMQ. Setiap worker memanggil job.updateProgress dengan objek berisi tahap dan persentase, dan query antrean dari controller otomatis membaca progres itu tanpa tabel khusus.
Langkah 1: endpoint SSE di NestJS
Endpoint stream di controller ditulis manual tanpa dekorator @Sse bawaan NestJS, karena saya butuh kontrol penuh atas header dan header autentikasi lewat query string. Bentuknya seperti ini, digeneralisasi dari kode produksi:
@Get('stream')
async stream(@Req() req: Request, @Res() res: Response) {
  res.writeHead(200, {
    'Content-Type': 'text/event-stream',
    'Cache-Control': 'no-cache',
    Connection: 'keep-alive',
  });

  const send = async () => {
    try {
      const [status, live, jobs, server] = await Promise.all([
        this.status(),
        this.live(),
        this.jobs('completed', '0'),
        readMetrics(),
      ]);
      res.write(`event: snapshot\ndata: ${JSON.stringify({ status, live, jobs, server })}\n\n`);
    } catch (e: any) {
      res.write(`event: error\ndata: ${JSON.stringify({ message: e.message })}\n\n`);
    }
  };

  await send();
  const timer = setInterval(send, 1000);
  req.on('close', () => clearInterval(timer));
}
Ada tiga hal yang membuat endpoint ini aman dipakai jangka panjang. Pertama, format SSE wajib punya garis kosong ganda setelah data, kalau tidak event tidak pernah terkirim. Kedua, event error ditangkap dengan try catch dan dikirim sebagai event bernama error, bukan dibiarkan melempar exception ke interval yang bisa membuat proses crash. Ketiga, listener close pada request wajib ada: kalau browser menutup tab, interval harus dihentikan, kalau tidak server menulis ke koneksi mati setiap detik selamanya.
Langkah 2: worker melaporkan progres via updateProgress
Bagian ajaibnya ada di sisi worker. BullMQ sudah punya mekanisme progres bawaan, jadi tidak perlu tabel progres khusus di database. Cukup satu helper report yang dipanggil di setiap tahap:
new Worker(QUEUE_NAME, async job => {
  const report = async (p: any) => {
    await job.updateProgress(p);
  };
  await report({ stage: 'claimed', label: 'CN masuk worker' });
  const result = await processCn(job.data.cn, report);
  await report({ stage: 'done', label: 'CN selesai', images: result.images });
  return result;
}, {
  connection: { url: process.env.REDIS_URL },
  concurrency: Number(process.env.QC_CONCURRENCY || 3),
});
Fungsi processCn menerima report sebagai parameter dan memanggilnya setiap kali tahap berganti. Karena updateProgress menyimpan objek progres langsung di metadata job di Redis, query antrean dari controller otomatis melihatnya tanpa sinkronisasi tambahan. Ini pola yang paling hemat: nol tabel, nol publish subscribe antar proses, progres tersimpan bersama job itu sendiri.
Langkah 3: menampilkan worker aktif dari query antrean
Daftar worker aktif didapat dari query job BullMQ berstatus active dan waiting. Triknya ada di pelestarian worker yang baru selesai: begitu job selesai, BullMQ memindahkannya ke daftar completed dan worker menghilang dari query active, padahal di layar kartu worker itu seharusnya masih tampil beberapa detik dengan status selesai supaya operator bisa membaca hasilnya. Solusinya cache ringan di memori controller:
@Get('live')
async live() {
  const jobs = await queue.getJobs(['active', 'waiting']);
  const now = Date.now();

  // bersihkan cache worker yang sudah tidak terlihat lebih dari 6 detik
  for (const [k, v] of recent) {
    if (now - v.seen > 6000) recent.delete(k);
  }

  const activeIds = new Set<string>();
  const mapped = jobs.map((j, i) => {
    activeIds.add(String(j.id));
    const e = {
      worker: i + 1,
      id: String(j.id),
      cn: j.data.cn,
      state: j.processedOn ? 'active' : 'waiting',
      progress: j.progress,
    };
    if (e.state === 'active') recent.set(e.id, { ...e, seen: now });
    return e;
  });

  const done = Array.from(recent.values())
    .filter(v => !activeIds.has(v.id))
    .map(v => ({ ...v, state: 'done',
      progress: { ...v.progress, stage: 'done', label: 'CN selesai' } }));

  return [...mapped, ...done];
}
Dengan begini kartu worker tidak menghilang seketika saat job selesai, tapi memudar enam detik kemudian. Detail kecil yang membuat dashboard terasa hidup dan tidak berkedip.
Langkah 4: satu EventSource di frontend Next.js
Di frontend, seluruh logika koneksi ditulis sekali di komponen shell yang membungkus semua halaman. Komponen lain tinggal membaca context, tanpa membuka koneksi sendiri:
useEffect(() => {
  if (!auth) return;
  const es = new EventSource(API + '/stream?auth=' + encodeURIComponent(token()));

  es.addEventListener('snapshot', e => {
    const d = JSON.parse(e.data);
    setS(d.status);
    setLive(d.live);
    setJobs(d.jobs || []);
    setServer(d.server || null);
    CACHE.s = d.status; CACHE.live = d.live;
    CACHE.jobs = d.jobs || []; CACHE.updated = Date.now();
    setConn('live');
  });

  es.onopen = () => setConn('live');
  es.onerror = () => setConn('reconnecting');

  return () => { es.close(); };
}, [auth]);
Dua jebakan yang saya alami di sini. Pertama, EventSource tidak bisa mengirim header kustom, jadi token autentikasi dilewatkan lewat query string dan backend harus menerima keduanya: header x-auth untuk fetch biasa dan query auth untuk SSE. Kedua, cache module-level penting untuk navigasi antar halaman: tanpa cache, setiap pindah halaman me-remount shell dan semua data kosong sampai snapshot pertama datang satu detik kemudian, yang terlihat seperti berkedip. Dengan cache, halaman baru langsung render data terakhir yang diterima.
Langkah 5: metrik server ikut dalam snapshot yang sama
Metrik server seperti CPU, RAM, storage, dan GPU dibaca pakai modul os Node, df untuk disk, dan nvidia-smi untuk GPU, lalu digabung ke snapshot SSE yang sama. Prinsip yang saya pegang: GPU hanya dibaca fail-soft, kalau nvidia-smi tidak ada di mesin, field GPU dikosongkan dan snapshot tetap terkirim. Monitoring yang crash karena satu metrik hilang lebih buruk daripada monitoring tanpa metrik itu.
Insiden nyata: pool PostgreSQL yang jebol karena SSE
Bagian ini pelajaran paling mahal dari seluruh proyek. Suatu hari dashboard tiba-tiba lambat, halaman jobs tidak mau loading, padahal login masih jalan normal dan PM2 menampilkan semua proses online. Setelah ditelusuri, endpoint jobs dan detail jobs menggantung, tapi kalau query SQL-nya dijalankan langsung lewat koneksi baru hasilnya keluar dalam 230 milidetik.
Penyebabnya kombinasi dua hal. SSE stream saya menjalankan empat query setiap detik per koneksi dashboard yang terbuka, dan pool koneksi pg bawaan cuma punya batas 10. Ditambah ada sesi lain yang menahan advisory lock, dalam hitungan menit seluruh slot pool terisi dan semua endpoint yang butuh database ikut menggantung, sementara login yang tidak menyentuh database tetap merespons sehingga terlihat seperti sehat.
Perbaikannya berlapis. Pool dinaikkan ke 25 koneksi dengan idle timeout 30 detik dan statement timeout 15 detik supaya query macet tidak bisa menahan slot selamanya. Query agregat mahal di status diberi cache 5 detik, jadi walaupun sepuluh dashboard terbuka, backend hanya menjalankan query agregat sekali per lima detik, bukan sepuluh kali per detik. Dan interval SSE ditambah guard try catch supaya satu query gagal tidak meruntuhkan proses. Sejak itu insiden serupa tidak terulang.
Uji coba dan hasilnya
Hasil akhirnya dashboard dengan lima kartu metrik di atas, panel monitoring server di kiri, live worker activity di kanan, dan tabel riwayat job di bawah. Semua bergerak setiap detik tanpa refresh. Worker card menampilkan nomor worker, CN yang diproses, chip status, tahap saat ini, nama gambar, dan progress bar dengan persentase. Job selesai tertahan enam detik sebelum menghilang.
Untuk verifikasi, halaman dibuka sambil pipeline berjalan penuh: kartu metrik harus sinkron dengan query database langsung, progress bar harus bergerak naik sesuai tahapan gambar yang diproses, dan tab Network di devtools harus menunjukkan satu koneksi stream saja yang tetap terbuka, bukan puluhan request polling. Koneksi tetap satu meski pindah-pindah halaman berkat cache module-level.
Penutup dan rangkuman keputusan
Rangkuman keputusan konfigurasi yang saya ambil: satu endpoint SSE berisi snapshot gabungan alih-alih banyak endpoint kecil, progres worker via updateProgress BullMQ tanpa tabel tambahan, cache memori enam detik untuk worker yang selesai, satu EventSource di shell dengan context React, autentikasi SSE lewat query string karena EventSource tidak bisa kirim header, pool pg 25 koneksi dengan statement timeout, dan cache status 5 detik untuk melindungi database dari banyak dashboard terbuka.
Kalau kamu baru mau mulai memakai BullMQ di NestJS, dua artikel sebelumnya membahas alasan migrasi dari n8n ke BullMQ dan konfigurasi BullMQ dari nol di NestJS. Dashboard ini adalah lapisan ketiga dari sistem yang sama: antrean dan workernya dulu, sekarang mata untuk memantau keduanya. Silakan coba polanya, dan semoga pipeline kamu tidak lagi jadi kotak hitam seperti milik saya dulu.