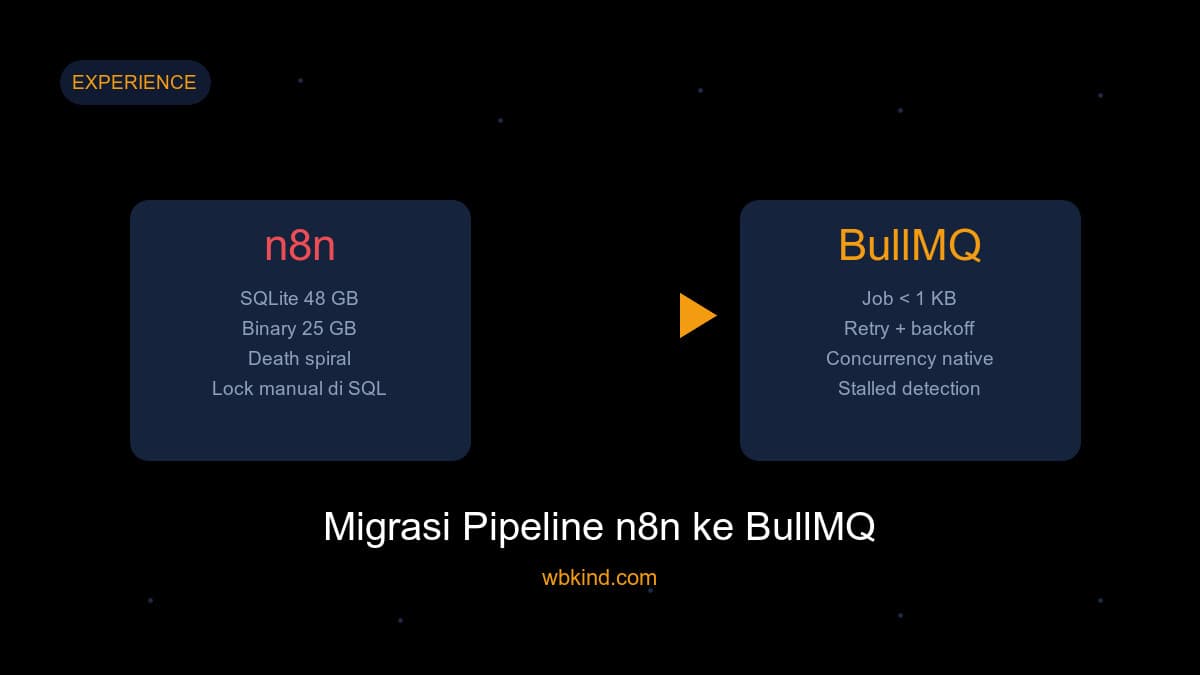
Artikel sebelumnya bercerita kenapa saya memindahkan pipeline n8n ke BullMQ. Kali ini bagiannya yang teknis: bagaimana konfigurasi BullMQ di NestJS dari nol, lengkap dengan pola yang terbukti jalan di produksi. Semua kode di sini digeneralisasi dari pipeline quality control foto yang memproses ribuan gambar per hari, jadi bukan contoh main-main.
Struktur dasar: Queue, Worker, dan job
BullMQ punya tiga aktor. Queue sebagai producer tempat kita menambahkan job. Worker sebagai consumer yang mengeksekusi job. Dan job sendiri, yaitu payload kecil yang lewat keduanya lewat Redis. Satu Queue bernama qc akan otomatis membuat key-key di Redis dengan prefix bull:qc, jadi Anda tidak perlu membuat schema apa pun secara manual.
Di NestJS saya memilih pola paling sederhana: Queue dibuat sebagai singleton di file terpisah, lalu di-import langsung ke controller. Tidak perlu dynamic module atau provider khusus kalau arsitektur Anda masih satu service.
// queue.ts
import { Queue } from 'bullmq';

export const QC_QUEUE = 'qc';
export const qcQueue = new Queue(QC_QUEUE, {
  connection: { url: process.env.REDIS_URL },
});
Koneksi hanya butuh URL Redis. Di produksi saya pakai satu Redis khusus untuk queue dengan port berbeda dari cache, supaya proses FLUSHDB sembarangan di cache tidak ikut melenyapkan antrean.
Menambahkan job dengan retry dan backoff
Job ditambahkan lewat method add. Dua opsi yang selalu saya isi: attempts untuk jumlah percobaan, dan backoff untuk jeda antar percobaan.
await qcQueue.add('qc', { cn: 'CN12345' }, {
  attempts: 2,
  backoff: { type: 'fixed', delay: 5000 },
});
Kalau worker melempar error, job tidak langsung masuk failed. BullMQ menunggu 5 detik lalu menjalankan ulang sampai attempts habis. Dengan attempts 2, satu retry berarti job Anda tahan terhadap kegagalan sesaat seperti OCR server yang tiba-tiba timeout atau download yang gagal karena jaringan, tanpa satu baris try-catch pun dari Anda.
Satu aturan penting: isi job dengan data sekecil mungkin. Job saya hanya berisi cn, satu string nomor connote, di bawah 1KB. Gambar dan detail lain diunduh oleh worker langsung dari sumbernya. Payload besar yang lewat queue itu mimpi buruk hygiene Redis, dan kalau Anda datang dari n8n, ini kebiasaan lama yang wajib dibuang.
Worker dengan concurrency
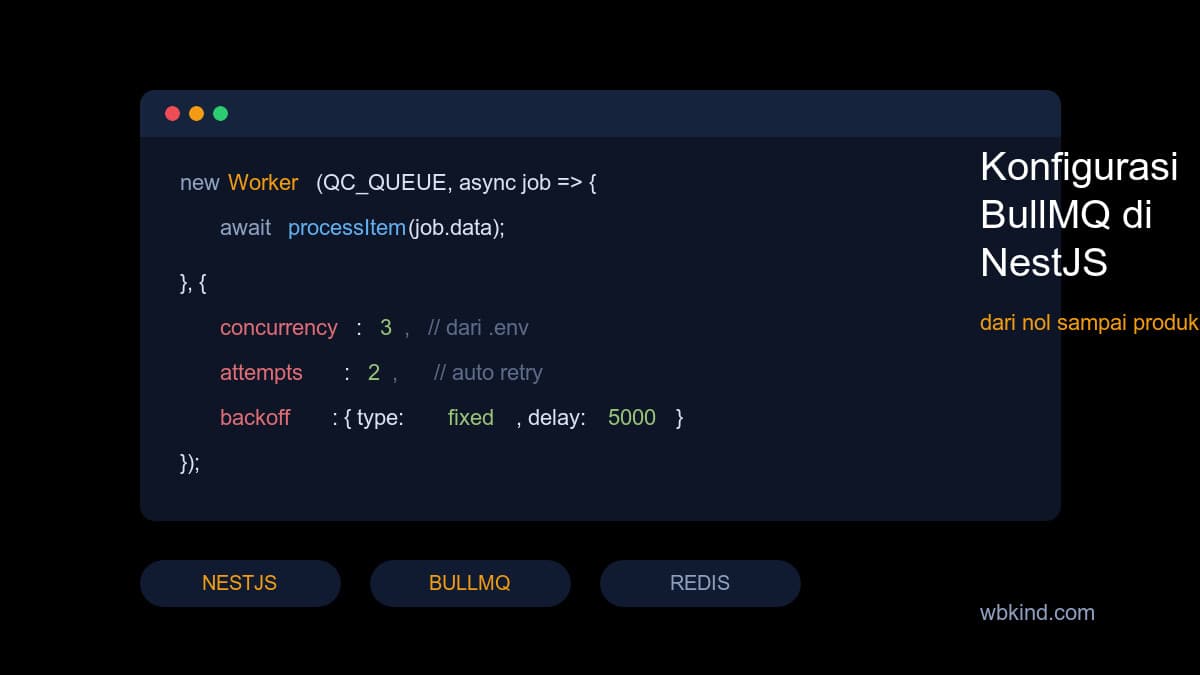
Worker adalah tempat eksekusi sesungguhnya. Opsi concurrency menentukan berapa job diproses paralel oleh satu proses worker.
// worker.ts
import { Worker } from 'bullmq';
import { QC_QUEUE } from './queue';

new Worker(QC_QUEUE, async (job) => {
  const report = async (stage: string, label: string) => {
    await job.updateProgress({ stage, label });
    console.log(JSON.stringify({ job: job.id, ...job.data, stage }));
  };

  await report('claimed', 'job masuk worker');
  const result = await processItem(job.data.cn, report);
  await report('done', 'job selesai');
  return result;
}, {
  connection: { url: process.env.REDIS_URL },
  concurrency: Number(process.env.QC_CONCURRENCY || 3),
});
Method updateProgress itu penting kalau Anda punya dashboard. Nilainya bisa dibaca dari event worker on progress, dan di project saya dipipe ke SSE sehingga frontend menampilkan stage tiap job secara live. Progress bukan cuma angka persen, bisa object berisi stage dan label.
Concurrency dibaca dari environment saat boot, bukan di-hardcode. Dengan begitu menaikkan paralelisme dari 3 ke 6 cukup ubah angka di settings lalu restart, tanpa deploy ulang. Sesuaikan angkanya dengan kapasitas downstream: worker saya memanggil OCR server, jadi concurrency harus mengikuti berapa request yang sanggup ditangani OCR, bukan sebesar mungkin.
Alur lengkap dengan scheduler
Di praktiknya queue jarang berdiri sendiri. Pola saya: scheduler interval mengambil item baru dari database, lalu menambahkan job. Fungsi tick di bawah ini berjalan tiap 20 detik lewat setInterval biasa.
let sched: ReturnType<typeof setInterval> | null = null;

export async function tick() {
  const item = await claimItem(); // atomic claim dari Postgres
  if (item) {
    await qcQueue.add('qc', { cn: item.cn }, {
      attempts: 2,
      backoff: { type: 'fixed', delay: 5000 },
    });
    await tick(); // isi terus sampai habis
  }
}
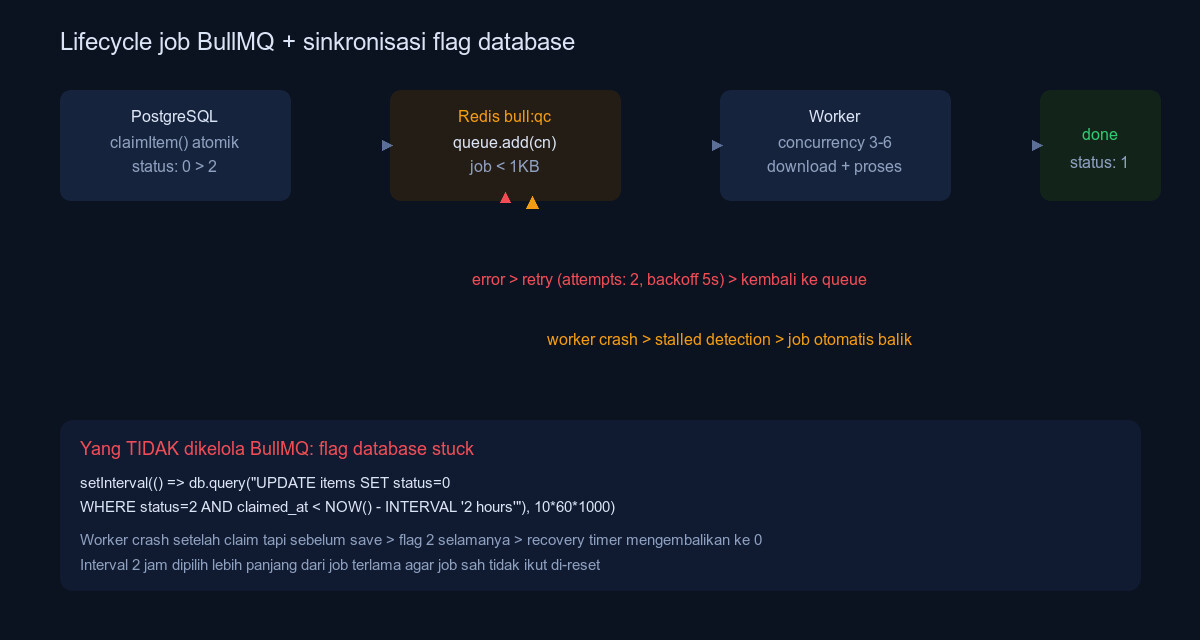
claimItem adalah query UPDATE dengan RETURNING yang menandai item jadi sedang diproses secara atomik. Ini mencegah dua scheduler mengambil item yang sama. Perhatikan ini bukan tugas BullMQ, tapi kombinasi claim di database plus eksekusi di queue, dan keduanya harus disinkronkan.
Monitoring dan kontrol antrean
Queue punya method getJobCounts yang mengembalikan jumlah job per state. Ini fondasi endpoint status.
@Get('status')
async status() {
  const counts = await qcQueue.getJobCounts(
    'wait', 'active', 'completed', 'failed'
  );
  return { running: !!sched, queue: counts };
}
Untuk start dan stop, jangan bunuh prosesnya. Pause queue supaya worker berhenti mengambil job baru, sementara job yang sedang jalan tetap selesai dengan baik.
@Post('stop')
async stop() {
  if (sched) { clearInterval(sched); sched = null; }
  await qcQueue.pause();
  return { started: false };
}
Yang tidak diberikan BullMQ
BullMQ menjaga job, bukan data Anda. Kalau worker crash di tengah eksekusi setelah item ditandai sedang diproses di database, job akan kembali ke antrean dan dijalankan ulang, tapi flag di database tetap terjebak di status sedang diproses selamanya. Item itu tidak akan pernah diambil lagi padahal job-nya sudah tidak ada.
Solusinya recovery timer sederhana di worker: secara berkala kembalikan item yang statusnya terlalu lama stuck.
setInterval(async () => {
  const r = await db.query(`
    UPDATE items SET status = 0
    WHERE status = 2
      AND claimed_at < NOW() - INTERVAL '2 hours'`);
  if (r.rowCount) console.log('recovered', r.rowCount, 'stuck items');
}, 10 * 60 * 1000).unref();
Interval dua jam dipilih lebih panjang dari durasi job terlama, supaya tidak ada job yang masih sah ikut di-reset. Bagian ini dulu tidak ada di pipeline n8n lama saya, dan CN yang bocor karena crash tidak pernah pulih sampai saya sadari dan menambahkannya.
Rangkuman keputusan konfigurasi
Concurrency dari environment agar bisa diubah tanpa deploy. Attempts dua sampai tiga dengan backoff fixed lima detik untuk kegagalan sesaat. Payload job di bawah 1KB, data besar diunduh worker langsung. Pause dan resume untuk kontrol antrean dari API. Dan recovery timer untuk menyinkronkan flag database yang tidak dikelola BullMQ. Lima keputusan itu saja sudah membuat queue Anda jauh lebih siap produksi daripada sekadar new Worker lalu selesai.
Kalau mau tahu kenapa saya sampai membangun semua ini, cerita lengkat migrasinya ada di artikel sebelumnya: Migrasi Pipeline n8n ke NestJS BullMQ.