Saya pernah membangun pipeline quality control foto POD dan BAST di atas n8n. Awalnya semua terasa cepat: tarik node Postgres, HTTP Request, Code, semuanya drag and drop. Tapi begitu volume naik ke ribuan foto per hari, masalah mulai bermunculan, dan sebagian besar bukan bug di workflow saya, melainkan sifat dasar n8n sebagai orchestrator yang menyimpan semua hal. Artikel ini cerita kenapa saya akhirnya memindahkan pipeline itu ke NestJS dan BullMQ, dan apa yang berubah setelah pindah.
Kondisi n8n saat itu
Pipeline-nya sederhana. Setiap 20 detik, scheduler mengambil satu connote dari Postgres, menandainya sedang diproses, mengunduh foto POD, mengirim ke OCR, memvalidasi hasilnya, lalu menyimpan ke tabel validasi. Untuk menghindari dua worker mengambil connote yang sama, saya pakai flag di database: 0 berarti belum diproses, 2 berarti sedang diproses, 1 berarti selesai. Pola yang kelihatan wajar di awal.
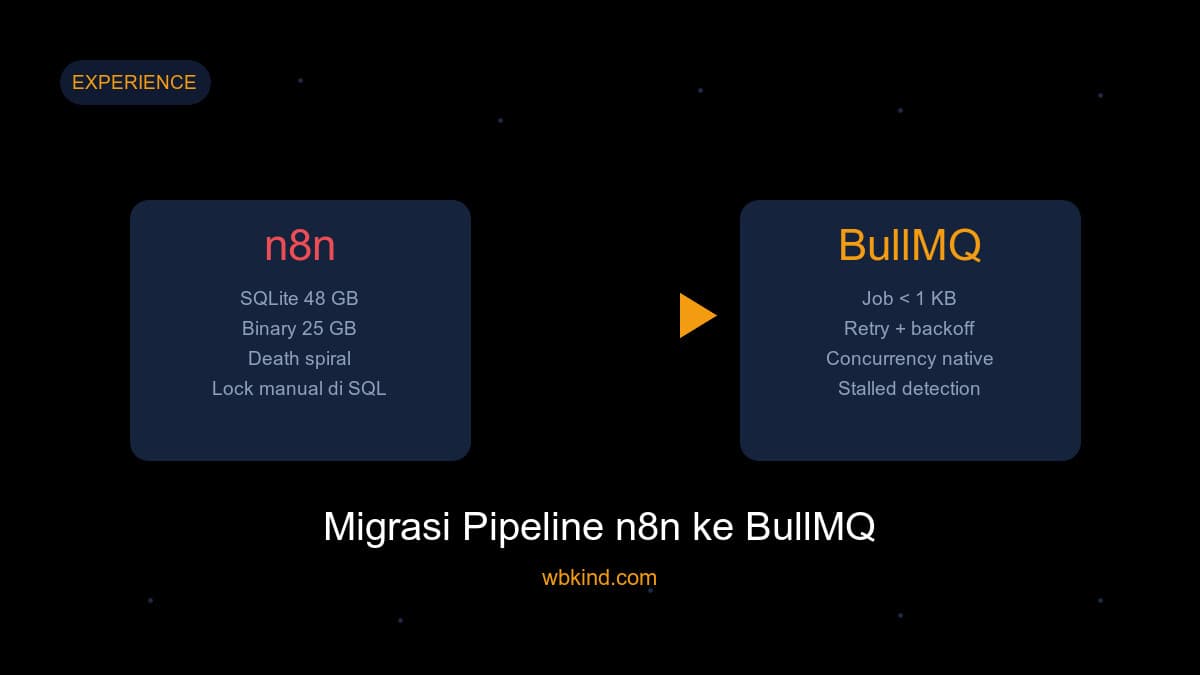
Tiga bulan kemudian, database SQLite n8n membengkak sampai 48GB. Setiap eksekusi workflow menyimpan snapshot JSON lengkap, termasuk base64 gambar hasil download. Binary file menumpuk 25GB di disk untuk keperluan preview UI yang jarang saya buka. Dan yang paling menyebalkan: saat load naik, eksekusi numpuk berstatus running, pool SQLite jenuh, dan n8n balas error “Database is not ready”. Eksekusi macet menunggu eksekusi lain, death spiral yang tidak bisa saya pecahkan dari dalam workflow.
Tanda bahwa antrian saya bukan antrian
Saat tracing insiden itu, saya sadar sesuatu yang memalukan. Flag 0, 2, 1 plus query pengecekan jumlah CN aktif di awal workflow, itu semua sebenarnya saya sedang membangun job queue dengan tangan di atas SQL. Saya menulis lock manual, retry manual, dan concurrency limiter manual, semua dalam bentuk node Code dan kolom database. Setiap kebutuhan queue baru berarti SQL baru plus logika baru, dan setiap bug race condition berarti siang saya habis untuk memperbaikinya.
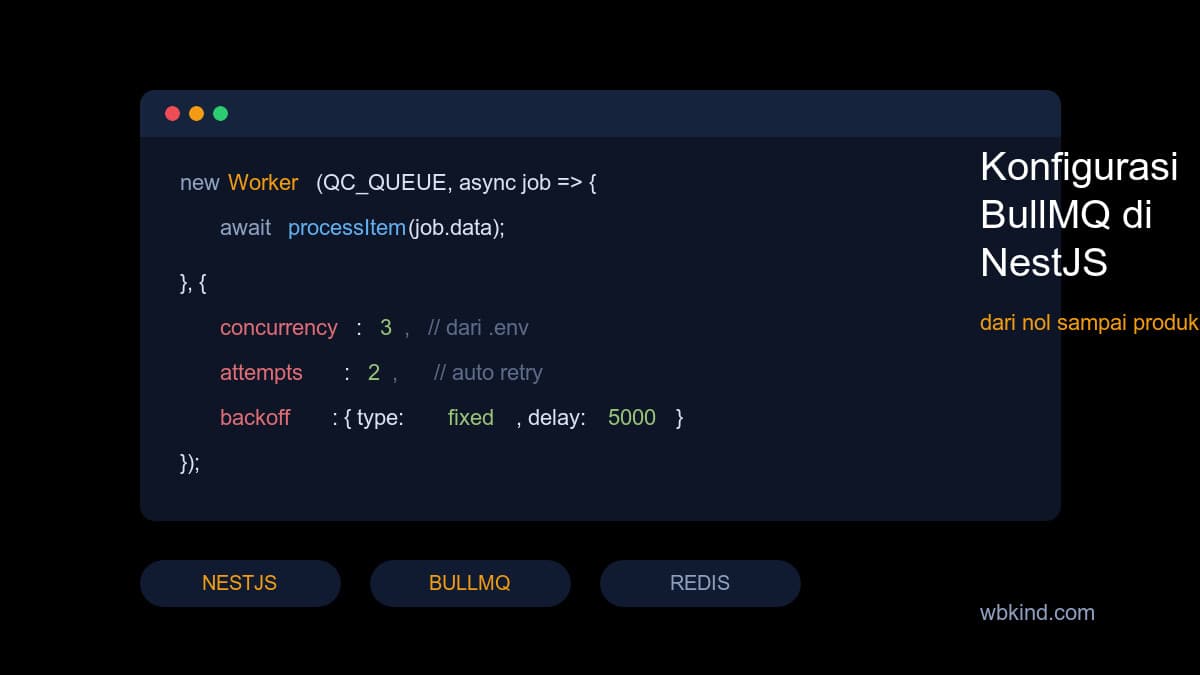
BullMQ memberikan hal yang sama secara native. Worker dengan concurrency 3 cukup satu baris konfigurasi. Job yang gagal di-retry otomatis dengan backoff. Worker mati mendadak, job stalled terdeteksi dan dikembalikan ke antrean. Semua yang saya tulis manual di n8n, gratis dari pustaka.
Arsitektur penggantinya
Penggantinya saya bangun dengan NestJS sebagai API server, BullMQ untuk antrean di Redis, dan Postgres tetap sebagai sumber data. Job di queue hanya berisi cn_no dan metadata, ukurannya di bawah 1KB, karena gambar diunduh langsung oleh worker, bukan di transport antar node. Frontend Next.js menampilkan live worker activity via SSE, jadi saya bisa lihat card CN muncul dan selesai diproses secara real time.
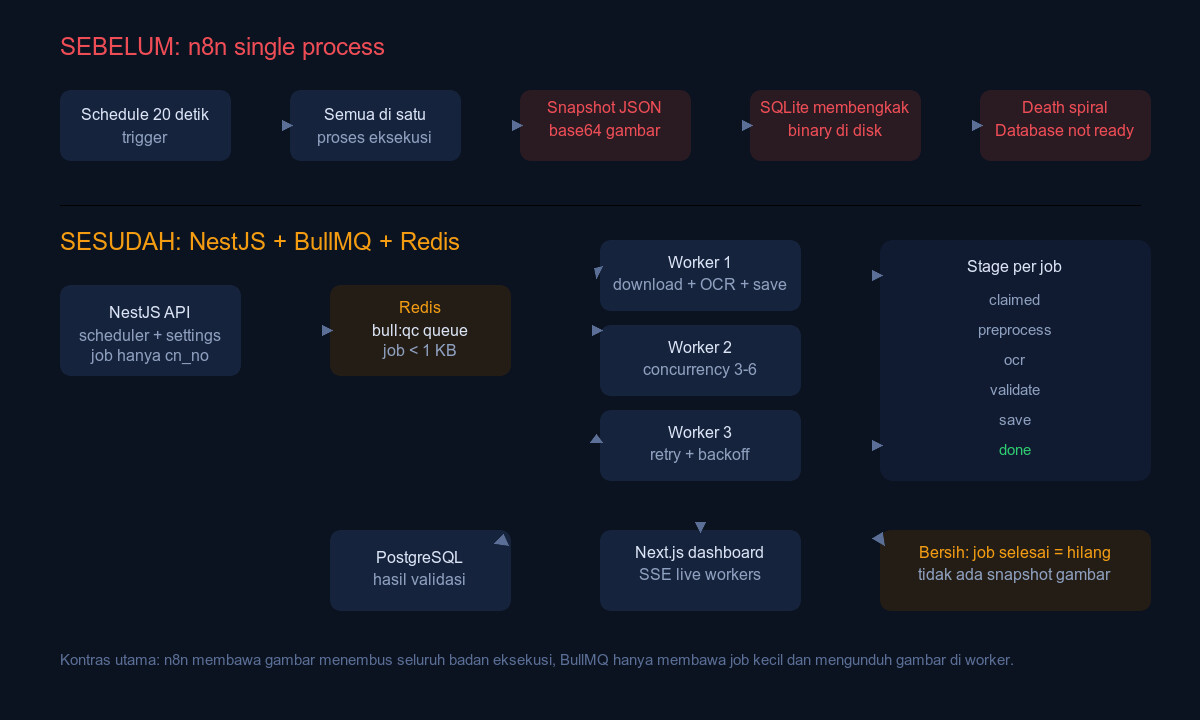
Yang paling terasa: hygiene data. n8n tidak pernah memegang gambar lagi, jadi tidak ada lagi binary menumpuk di disk. Job selesai lalu hilang dari Redis, tidak ada snapshot puluhan megabyte per eksekusi. SQLite 48GB itu tidak perlu di-VACUUM lagi karena tidak dipakai sama sekali.
Angka sebelum dan sesudah
Sebelum migrasi, satu eksekusi workflow berdurasi kerja nyata bisa membawa JSON 15MB atau lebih karena multi image per CN. Setelah pindah, log per job cuma baris stage: claimed, preprocess, ocr, validate, save, done. Pada window testing terakhir sebelum migrasi penuh, workflow lama memproses 10.247 gambar dalam semalam suntuk. Pipeline baru memproses volume yang sama dengan concurrency 3 tanpa satu pun death spiral, dan sekarang bisa dinaikkan sampai 6 hanya dengan mengubah angka di halaman settings, tanpa deploy ulang.
Kapan n8n masih pilihan yang benar
Saya tidak menyalahkan n8n. Untuk iterasi awal, n8n benar-benar menang: ubah prompt OCR, ubah aturan validasi, save, langsung jalan. Tim yang review lewat UI juga terbantu karena bisa membuka eksekusi dan melihat data lewat jalan. Migrasi ke kode baru masuk akal saat aturan sudah stabil, volume besar, dan kebutuhan reliability naik. Kalau workflow Anda masih berubah tiap minggu, tetap di n8n. Kalau Anda mulai menulis lock dan retry manual di dalam node Code, itu tanda antriannya sudah saatnya jadi kode sungguhan.
Pelajaran yang saya bawa
Yang pertama: kalau Anda butuh guard “satu item aktif” dengan flag SQL, Anda sedang menulis queue, dan lebih baik tulis di tool yang memang dibuat untuk itu. Yang kedua: orchestrator yang menyimpan semua perantara akan membuat disk Anda membengkak di volume tinggi, jauhkan payload besar dari badan eksekusi. Yang ketiga: concurrency, retry, dan stalled detection itu bukan fitur mewah, itu alasan utama pakai queue library. Tiga pelajaran itu yang membuat migrasi kali ini terasa bukan rewrite, tapi koreksi arsitektur.